不知不觉,今年又用了快一年的 AI。模型的能力还在稳步往前走,但说实话,对开发者来说,现在的能力已经完全够用了,真正拉开差距的是怎么用。
这大半年下来,我在这件事上又有了些新的心得。之前两篇(《Agent Coding 的个人最佳实践(2026.03 版)》 和 《Harnessing AI, not surrendering to it》)主要聊的是怎么让 AI 把代码写好、写对。这篇聊聊写代码之外的那些活,怎么也交给 AI。
那 AI 时代怎么成为一个 AI Native 的工程师?我的答案就一句话:要做什么、做得对不对,这两样攥在自己手里,其余的活都交给 AI。
围绕这个答案,先抛两个暴论:
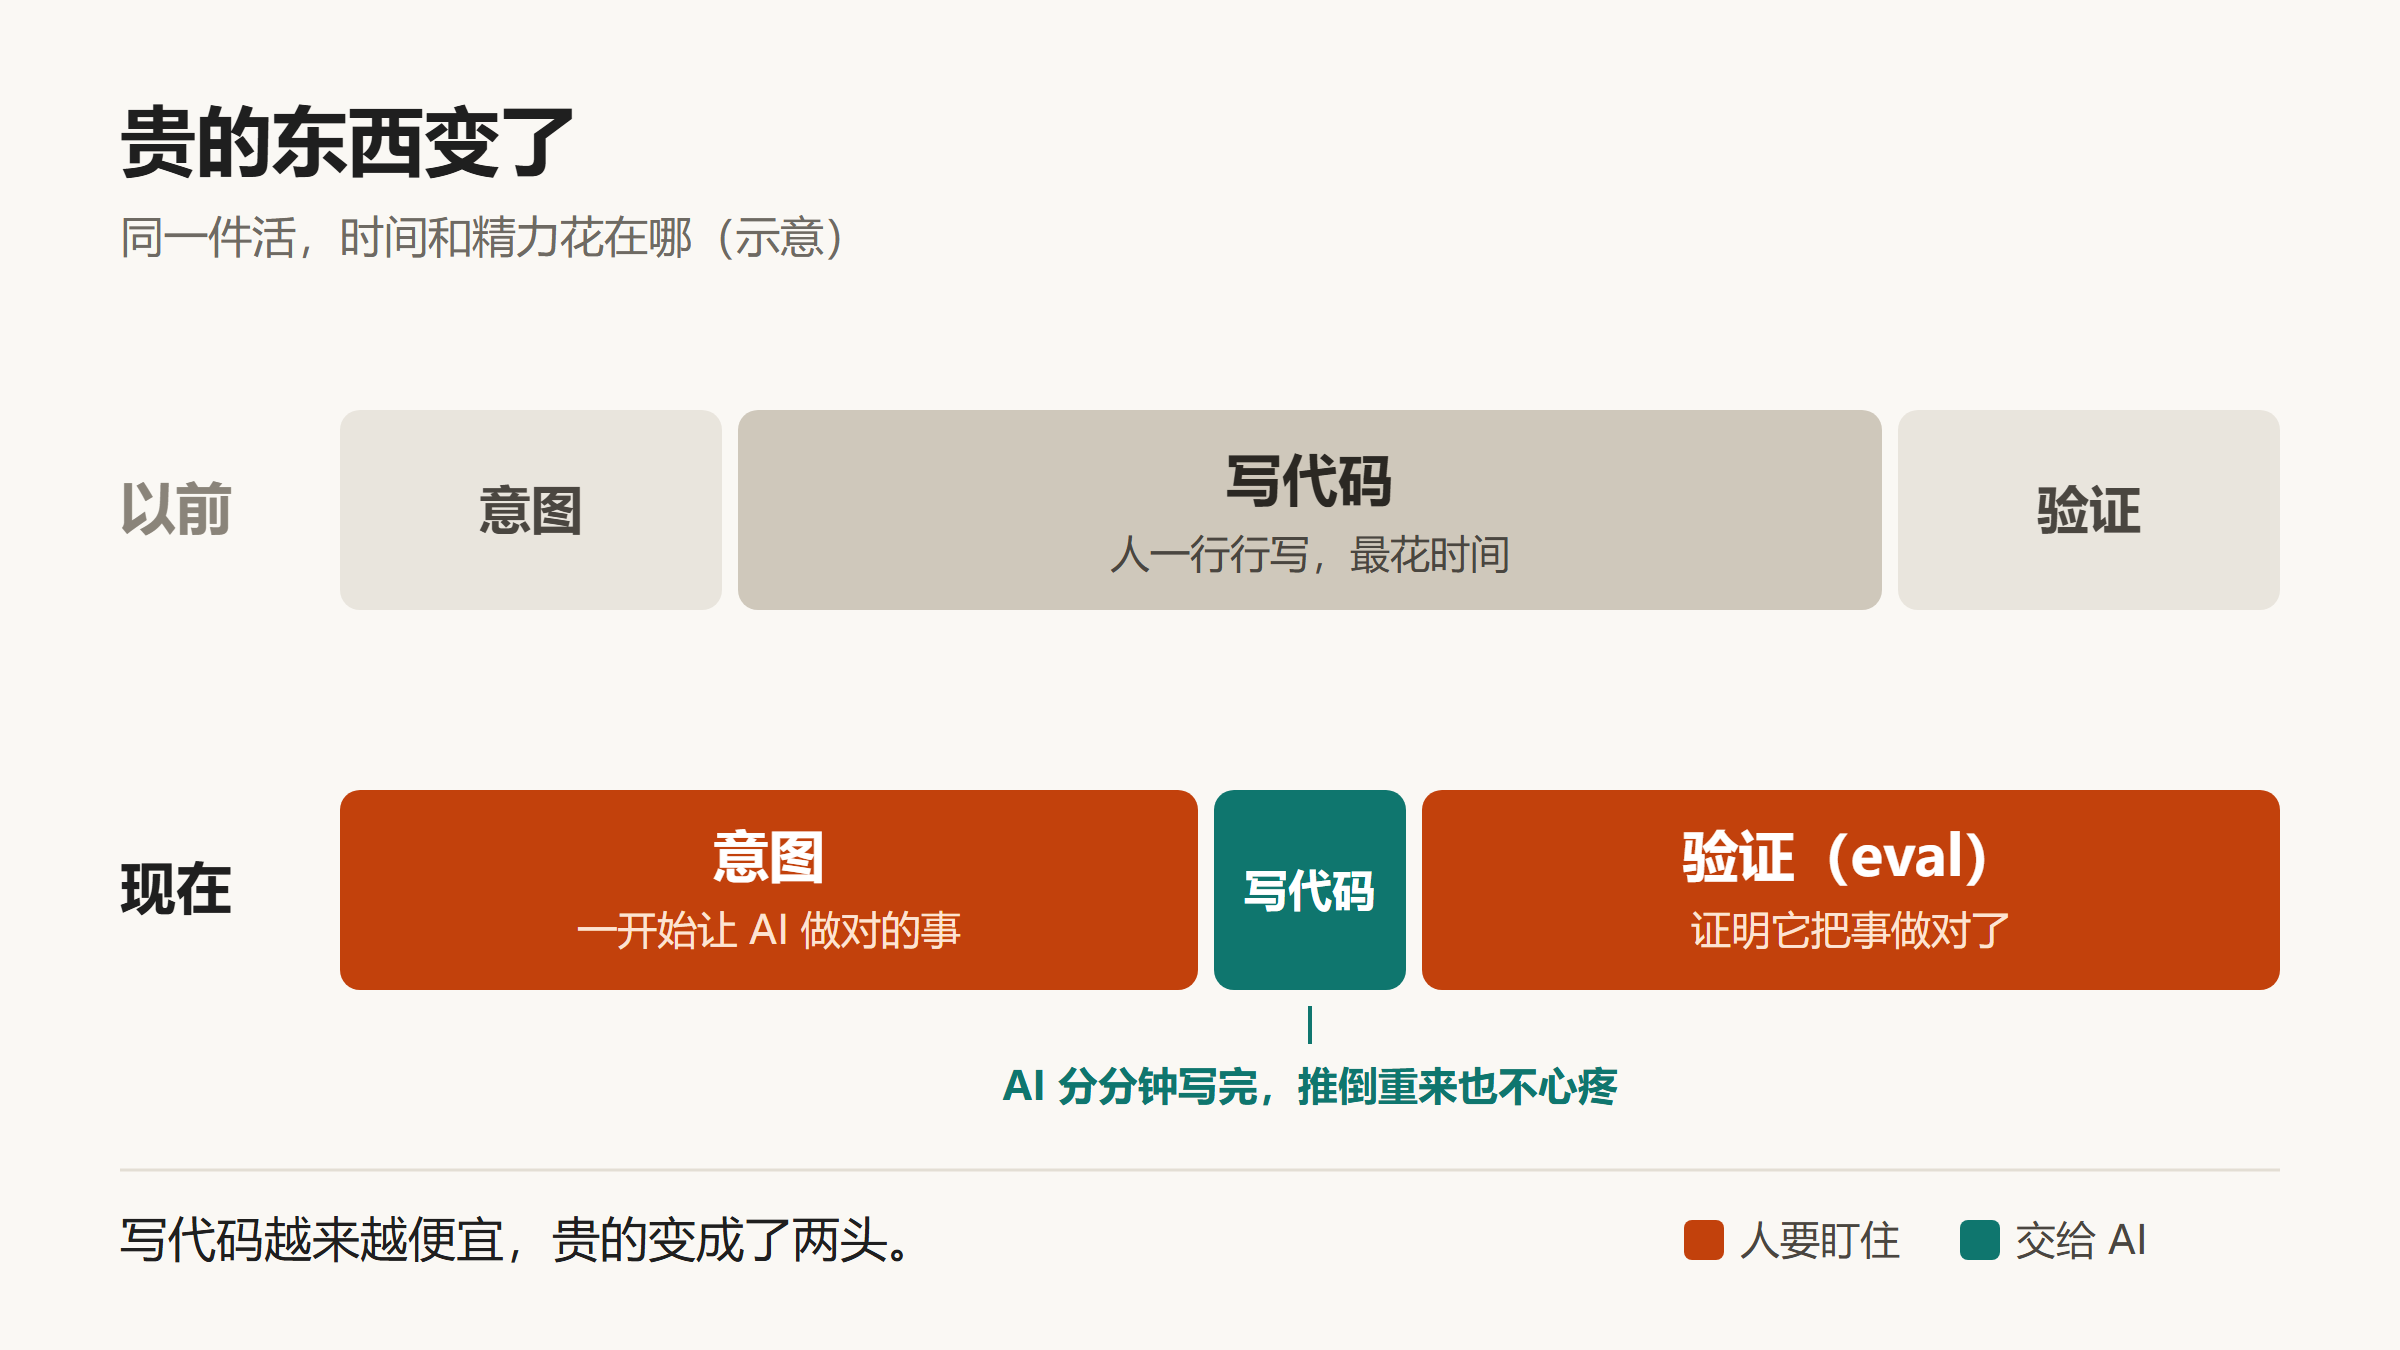
- 写代码现在是最便宜的事,最贵的是两头:一开始让 AI 做对的事,最后能证明它把事做对了。
- 所有工作环节都应该 AI Native(能交给 AI 的活都交给它)。如果你现在还没有把 AI 的能力用足,那在 AI 时代你已经落后了。
后面先把这两条挨个解释清楚,再讲我是怎么把活一块块交给 AI 的,最后聊聊 personal agent。
暴论一:写代码是最便宜的事
为什么说写代码最便宜?这个很好理解。AI 分分钟就能生成一大堆代码,这次实现有问题,推倒重来的成本非常低。
代码生成得这么快,人就成了最大的瓶颈,主要卡在两个地方。
一是你怎么保证 AI 的意图从一开始就是对的。 也就是它要做的事,到底是不是你想要的那件事。意图一旦偏了,它写得越快,偏得越远。我第一篇里提过一次翻车:在一个规模比较大的项目里,直接把改动点丢给 AI,结果它对需求的理解出了偏差,生成了一大堆结构混乱的代码,最后只能整个回退重来。那堆代码 AI 没几分钟就写完了,本身不值钱;真正花掉的,是我后面读它、试着改、最后发现改不动只能回退的那些时间。说到底,是一开始方向就错了。
二是你怎么保证 AI 生成的代码是正确的,结果怎么验证。 这就是 eval(评测验证)要解决的问题:用测试、检查脚本这类手段拿出证据,证明它真的做对了,而不是听它一句”已完成,测试通过”就信了。这块我在上一篇里专门聊过自己那套验证系统,这里就不展开了。
如果你大量用 GPT、Claude 这些模型实际写过代码,对这两点肯定很有感触,这也是我一直在探索的问题。代码已经不值钱了,值钱的是两件事:一开始让 AI 做对的事,最后能证明它把事做对了。
暴论二:所有工作环节都应该 AI Native
暴论一说的是写代码这一环里面什么最贵。跳出这一环看,光是写代码快,其实不够。
工作从来不只有写代码。处理 bug、分析需求、分析日志、查数据、测接口、部署上线,这一串都是工程师每天要干的活。现在写代码这一环被 AI 大大提速了,如果其他环节还用以前的方式手动处理,整条链就会卡在这些地方。你一会儿就把代码写完了,出了问题却要花半天手动翻日志、查数据库,这就跟不上写代码的速度了。
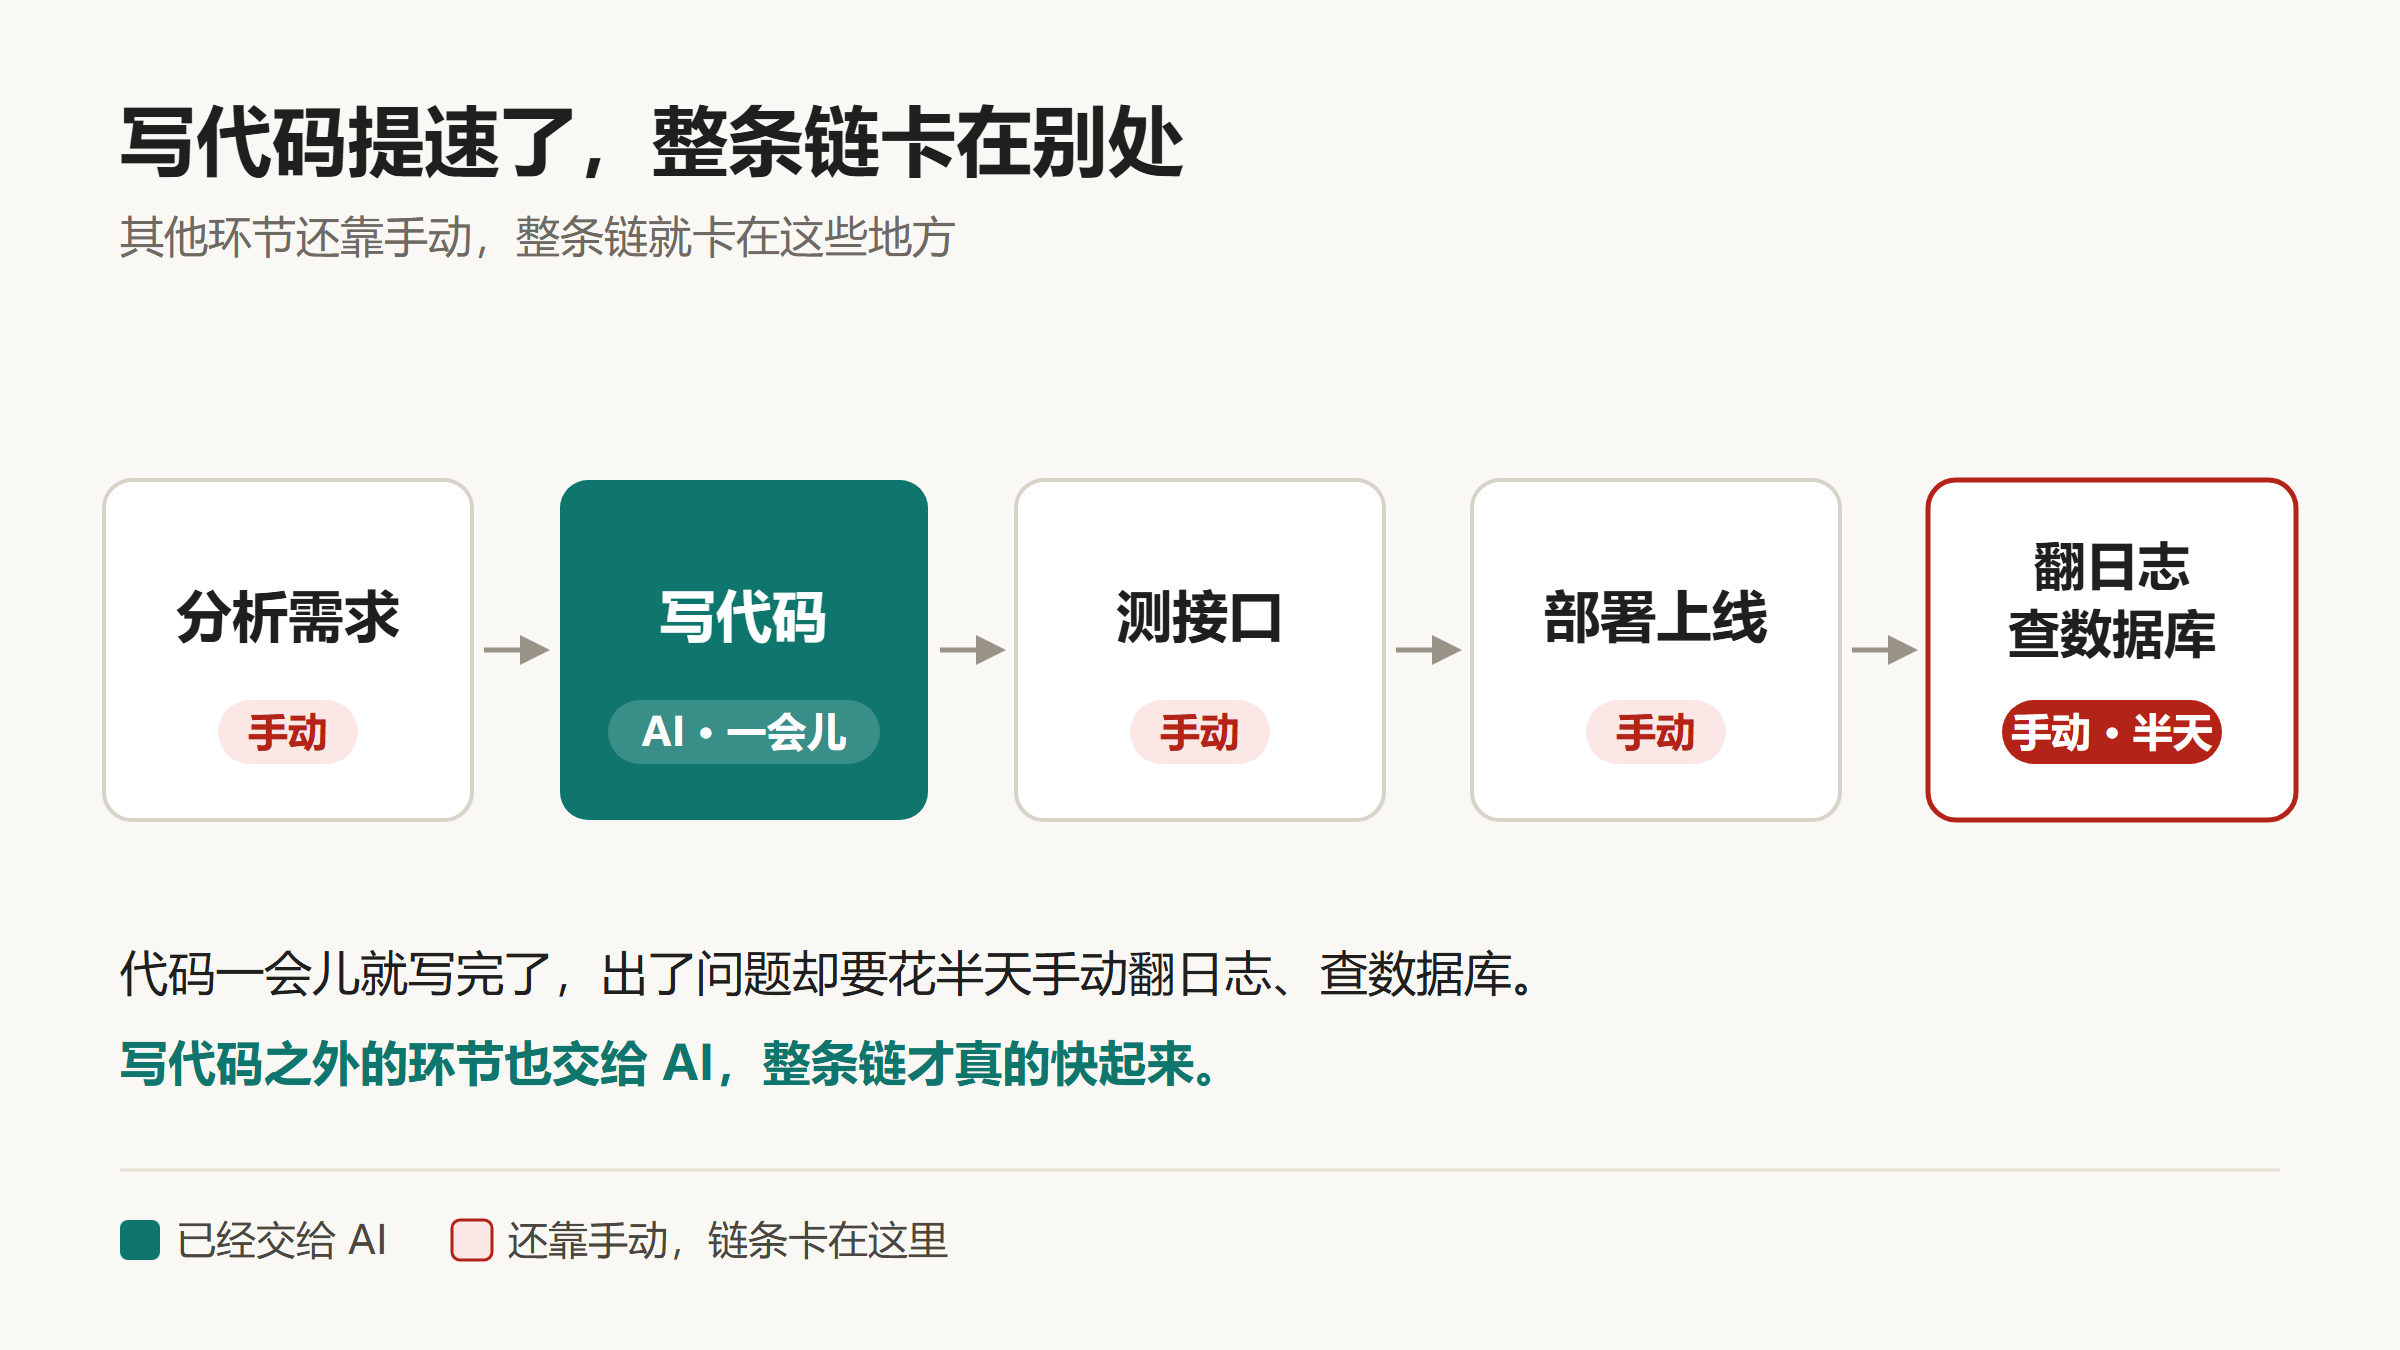
所以我说所有工作环节都应该 AI Native。这是一个没法逆转的趋势:写代码是最容易交给 AI 的那一环,它已经先变了,其他环节迟早都要跟上。
Anthropic 官方今年发过一篇讲 AI 时代软件开发流程的文章(The AI-native SDLC playbook),开头说的也是这件事:AI 让写代码变快了,但审批、评审、交接这些环节还按人的速度走,所以瓶颈从写代码挪到了计划、评审测试和部署。它讲的是团队的开发流程,我这里说的是个人的工作流,道理是一样的。
什么是 AI Native
那到底什么叫 AI Native?
我的理解是:不管通过什么方式,能交给 AI 做的事都应该交给它,别再自己手动去处理。换句话说,碰到一件活,先问一句”这事 AI 能不能干”,而不是默认自己上手。
接入的方式有很多。可以通过 MCP(让 AI 调用外部工具和服务的一套标准接口)、Skill(把一类任务的步骤和参考资料打包好,AI 用到时照着做)、CLI(命令行工具)这些方式,把能力接给 AI,让它自己去调用;也可以直接开发定制化的 Agent,专门去做某一类事。
顺带说一句,这几种方式里我个人最看好 CLI。CLI 天生就对 AI 友好:它本来就是 Unix 哲学下的默认工具,不用的时候什么都不占,随拿随用;模型训练时也见过海量的命令行用法,EJ Holmes 在 《MCP is dead. Long live the CLI》 里举的例子就是,让 Claude 跑一句 gh pr view 123,直接就能用。更关键的是,AI 还能用管道把不同 CLI 的能力自己组合起来,这一点 MCP 很难做到。所以我觉得以后的应用如果想面向 Agent,就得配一个 CLI。
当然,交给 AI 不等于什么都放手,安全和合规必须考虑进去。比如线上数据只让它查、不让它直接改,要改就走带审批的流程;敏感数据和高风险操作,不让 AI 自己拍板。
我是怎么做的:把能力拆小
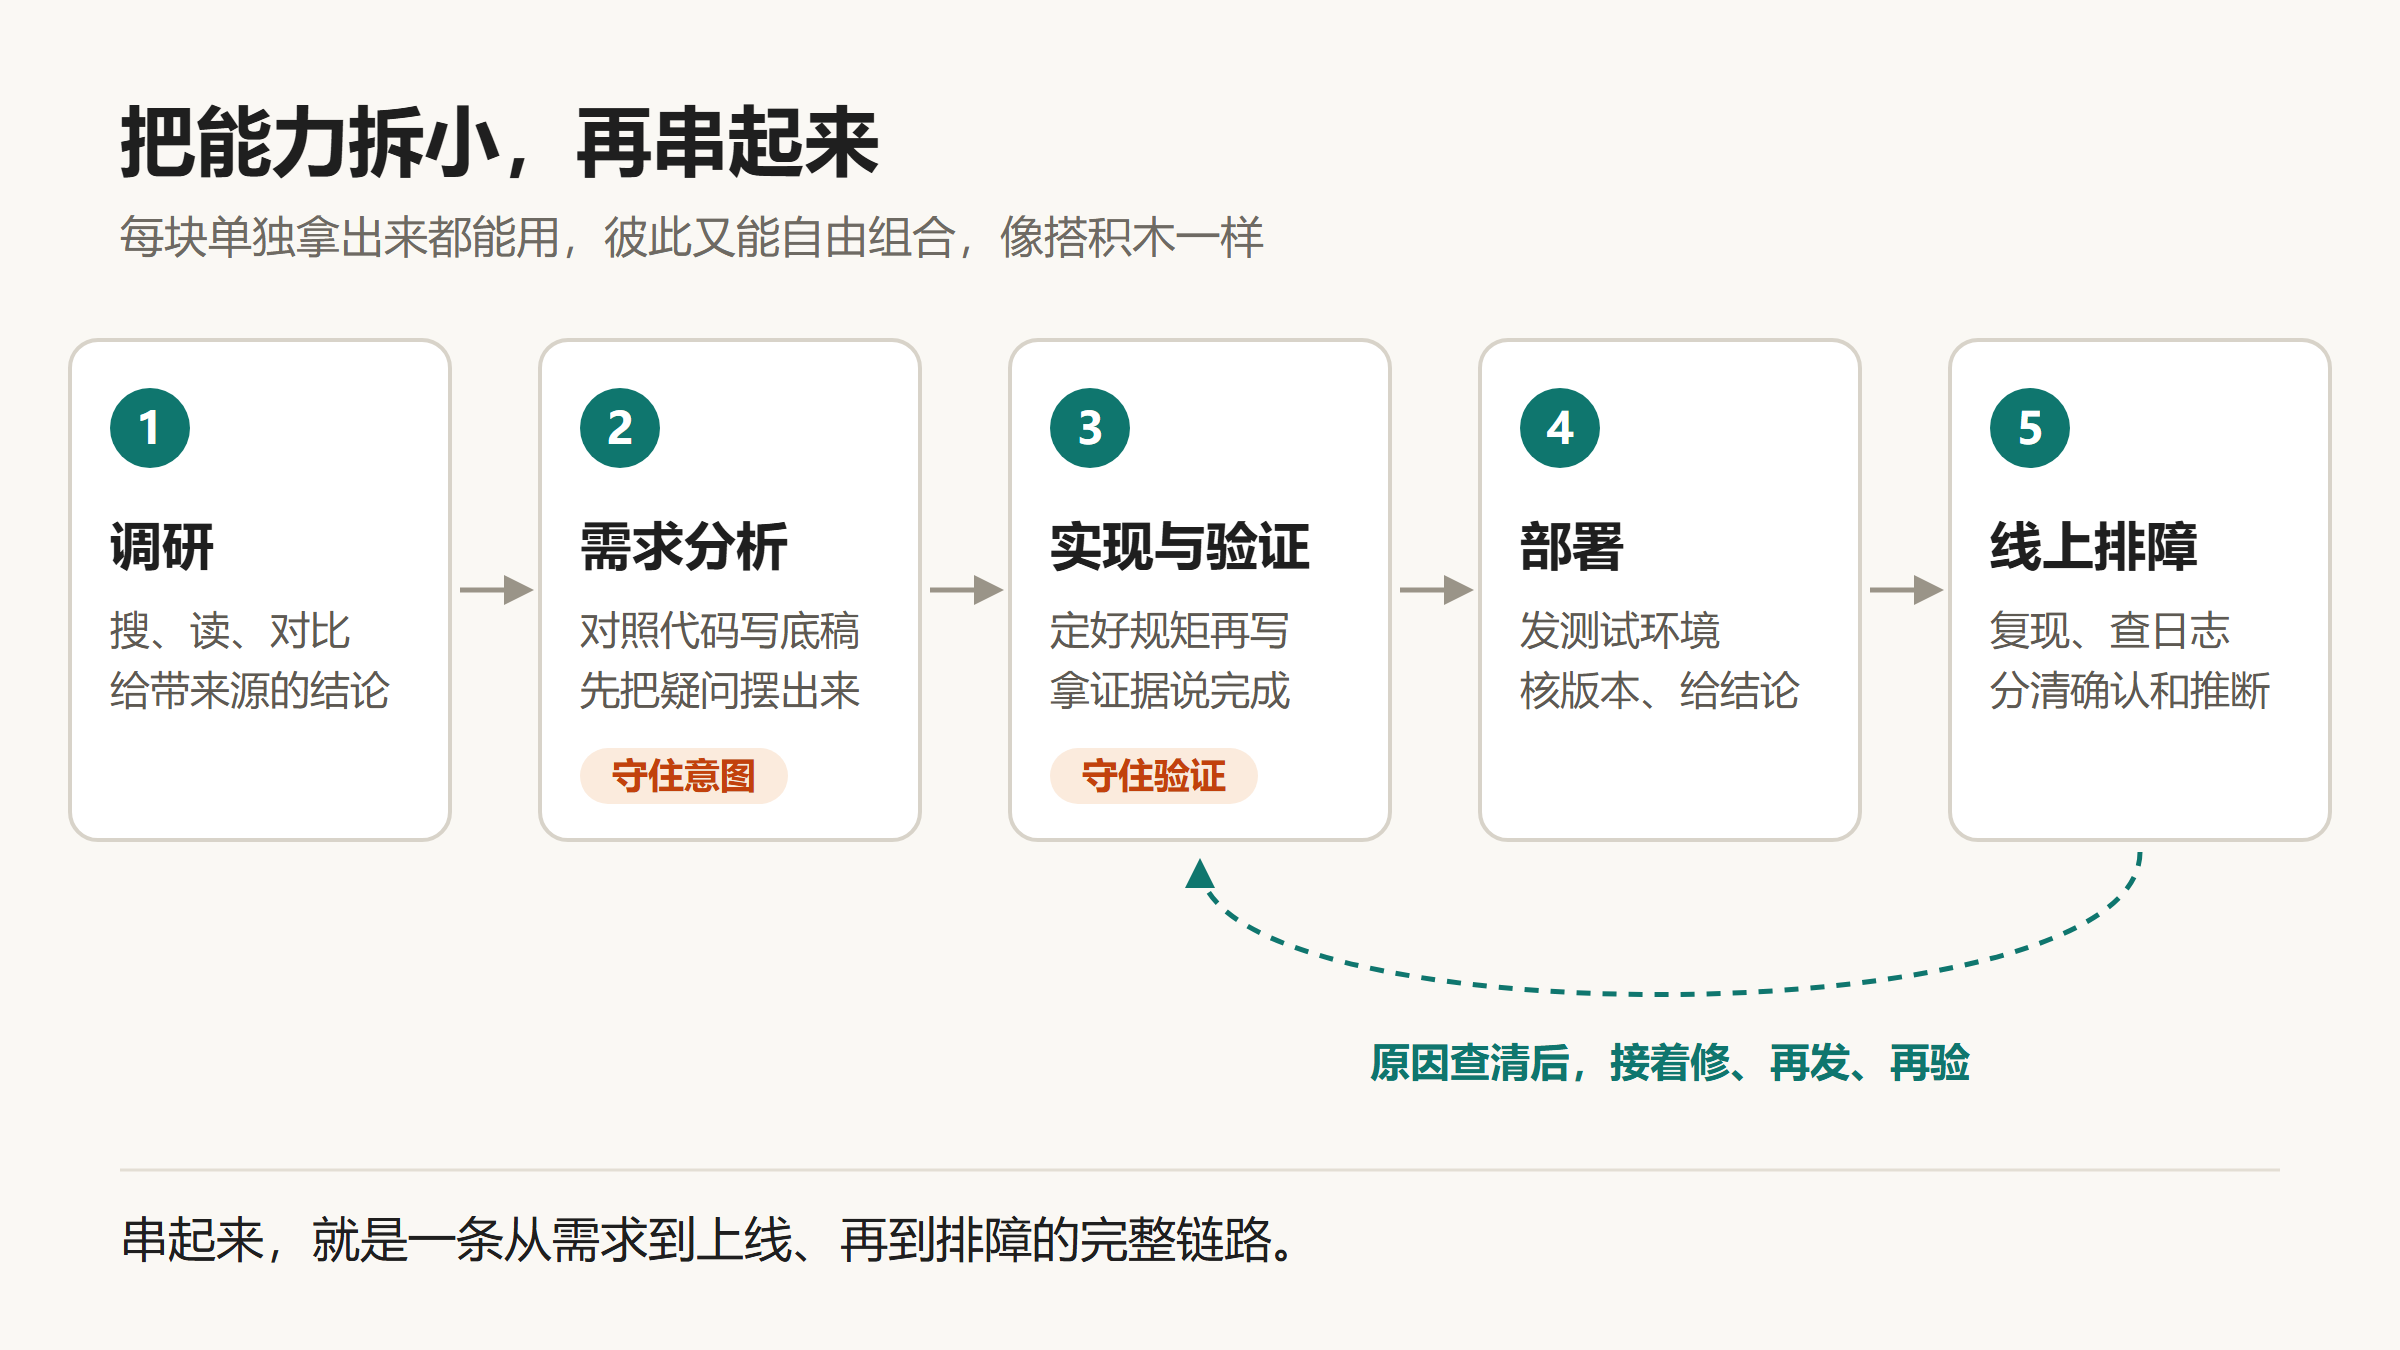
这里我不讲具体用了什么工具、怎么配置,只说思路:从你自己的工作流或者痛点入手,把工作拆成一个个能单独交给 AI 的小能力。我管这叫 AI Native 能力原子化,意思是每个能力单独拿出来就能用,彼此之间又能自由组合,像搭积木一样。
从工作流入手
按一件活从调研、需求到上线,再到线上出问题的顺序,我拆成了五块。
1. 调研能力
技术选型、读官方文档、看别人的开源实现、对比几种方案,这些都可以交给 AI 去搜、去读、去对比,最后给你一份带来源的结论。
2. 需求分析和拆解能力
让 AI 读需求文档(连同里面的图片),对照现有的代码和数据库,写出一份需求底稿:要改哪些地方、还有哪些疑问、表结构怎么建、上线前要准备什么。需求改了、疑问定了,再让它同步更新底稿。这一步最重要的不是让 AI 写代码,而是先帮你把不确定的地方暴露出来,这就是暴论一里说的”保证意图从一开始就是对的”。
3. 代码实现和验证能力
写代码之前先给 AI 定好规矩:只改任务要求的地方,不顺手重构,不加没要求的东西,照着周围代码的写法来,改完按固定格式自查汇报。写完也不是它说好了就算好,得有测试和检查拿出证据。
4. 部署能力
让 AI 把改动发到测试环境,然后自己核对:部署是不是成功了,跑的是不是这次的版本。修 bug 的话,就用当初复现问题的方式再走一遍,看部署后的日志,最后给出结论:通过、失败,还是证据不够没法判断。
5. 线上问题解决能力
线上出了问题,把报错信息或者现象描述丢给 AI,它自己去复现、查日志、查数据、确认线上跑的是哪个版本,最后给出结论,并且分清哪些已确认、哪些是推断、哪些还不知道,每一条都指向具体证据。原因查清以后,再接着修复、发测试环境、验证,最后把结论回写到缺陷管理系统里。
这五块单独拿出来都能用,串起来就是一条从需求到上线、再到排障的完整链路。
从痛点入手
另一个入口是痛点。有很多活以前只能人肉干,繁琐又费时,现在结合 AI 就容易多了。
比如测接口。以前要打开 Postman 这类工具,手动填地址、参数、鉴权信息,一个个点发送,再自己对着返回结果看对不对。再比如查数据库,以前要自己连库、写 SQL、翻结果。现在通过 Skill、MCP 或者 CLI 把这些能力接给 AI,你一句话说清楚要查什么、测什么,它直接去做,把结果和结论一起给你。
这类活你工作里肯定也有不少。经常重复、步骤又比较固定的手动操作,都可以考虑封装成 Skill 交给 AI。不知道从哪下手的话,可以先把上周干过的手动活列一遍,挑一个最烦的先交出去。
最后一步:做一个自己的 personal agent
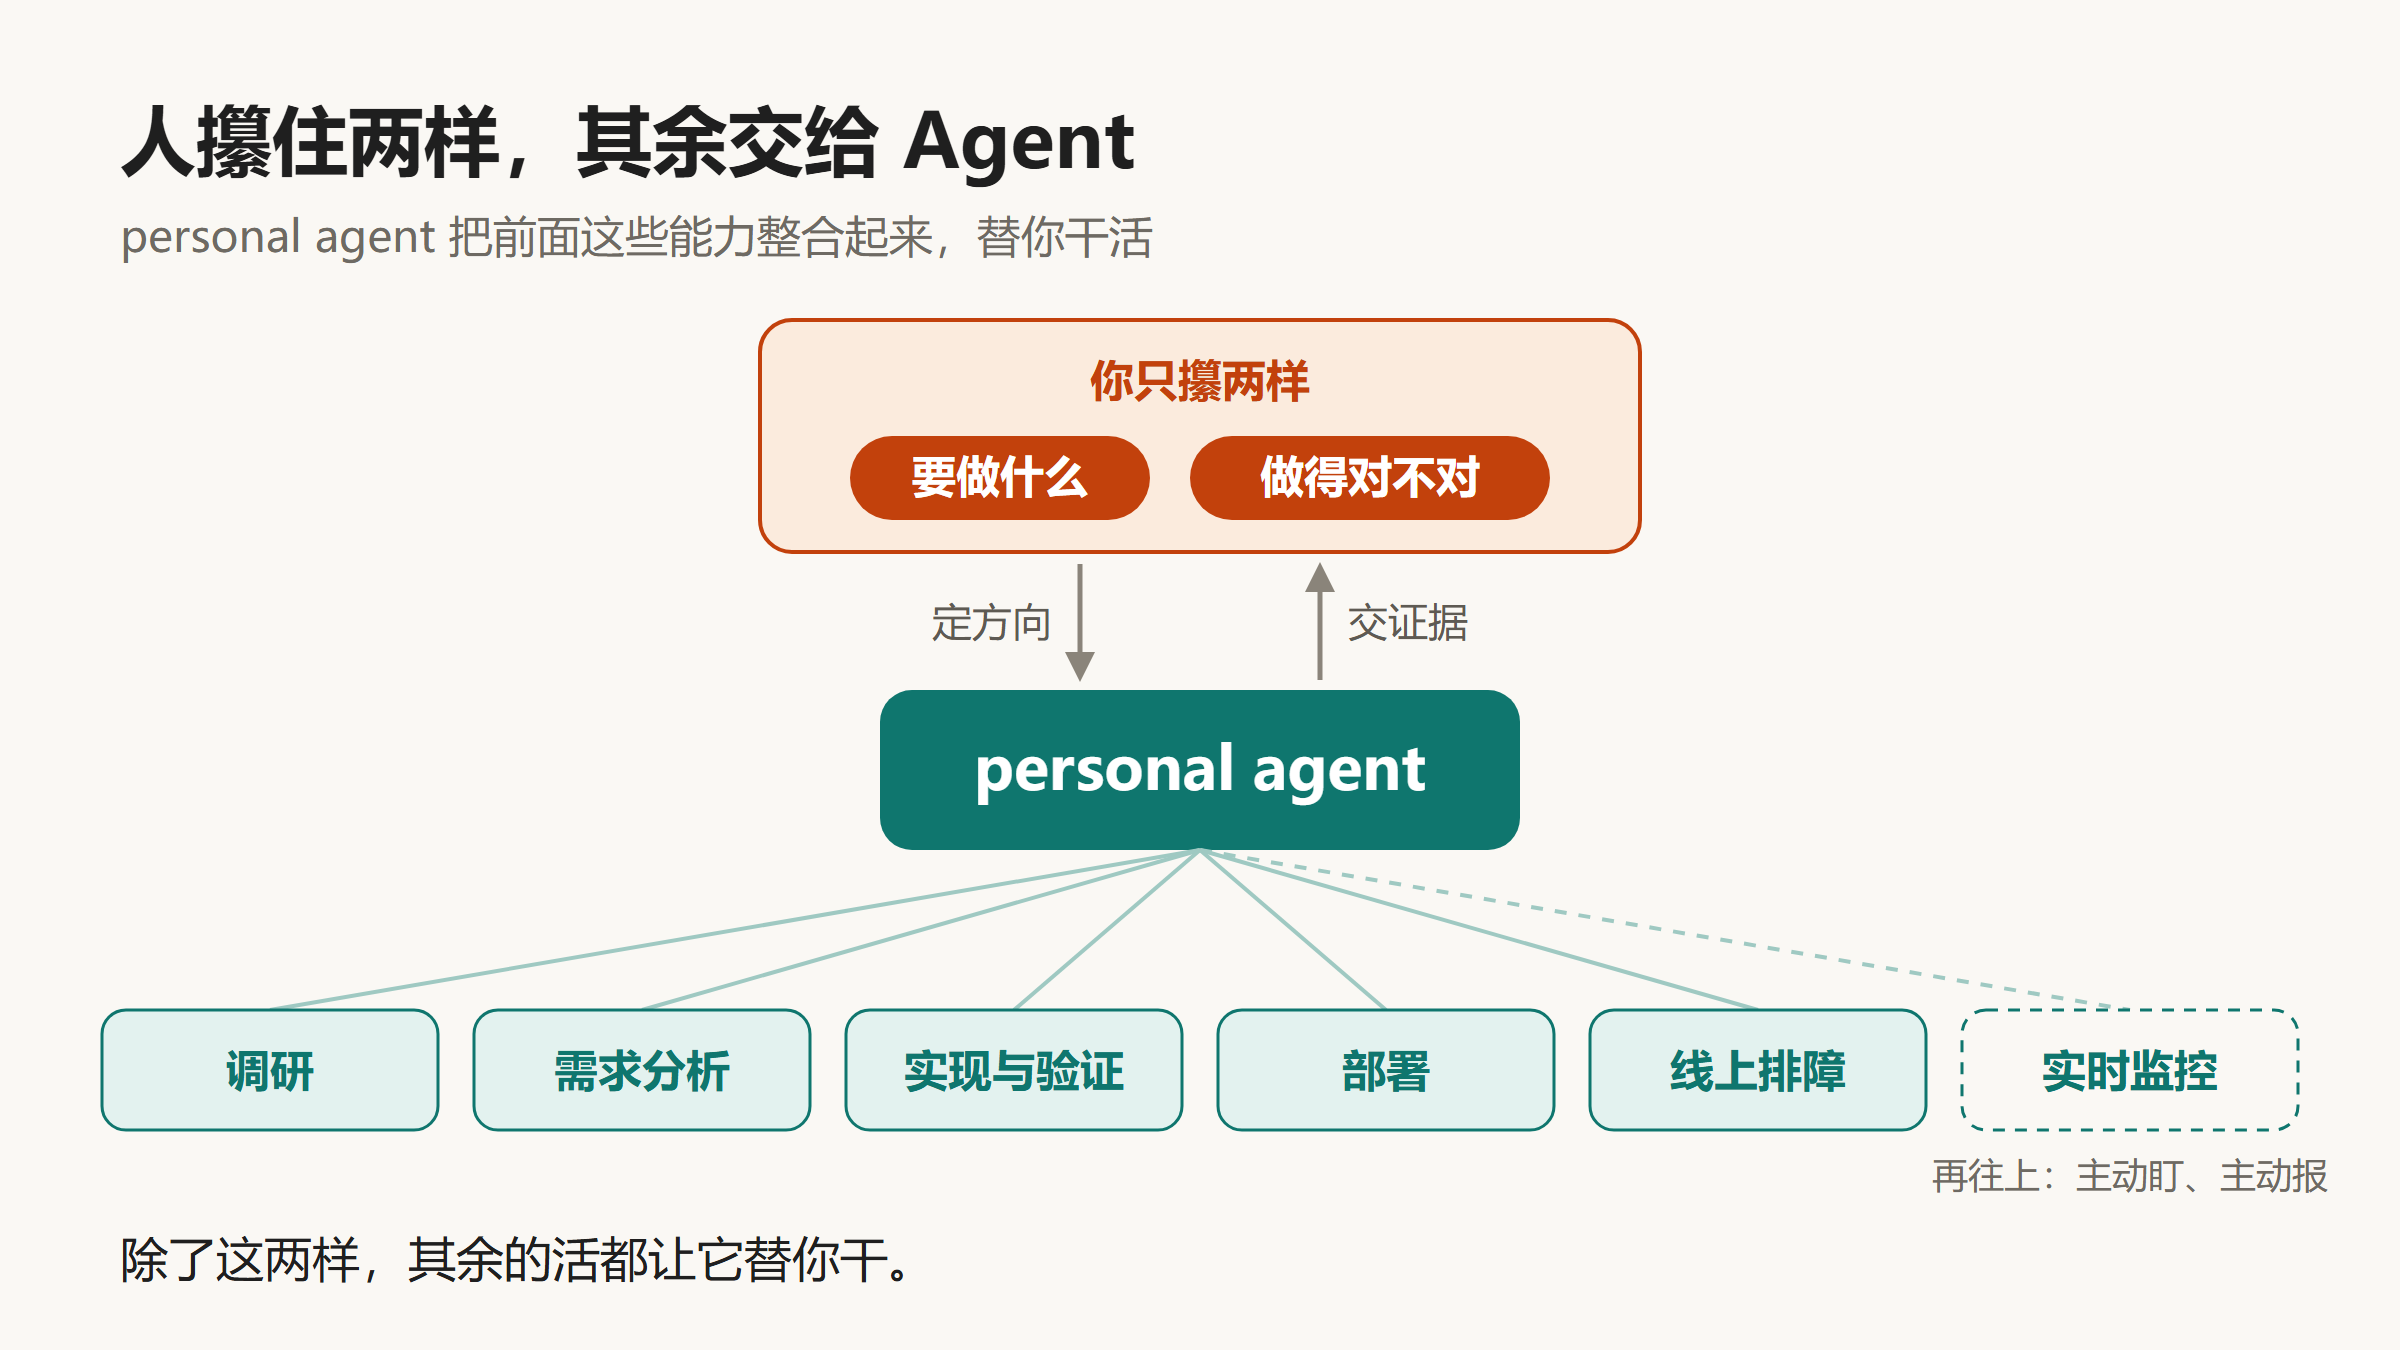
上面这些如果都做得比较好了,我认为最后一步是做一个属于自己的 personal agent(个人专属 Agent)。
它可以把上面这些能力整合起来,变成一个专门为你定制的工作助手。
再往上,还可以给它定制一些更高级的功能,比如实时监控:它自己盯着你关心的服务、指标或者消息,有异常就主动处理或者提醒你,不用等你去问它。Anthropic 那篇文章讲线上维护时也是这个思路:让 Agent 盯着线上,指标一越界就自己先诊断,再把发现写成新的需求交回给人。
说白了,就是把自己的做事方式都教给这个 personal agent,除了开头说的那两样,其余的活都让它替你干。
工作之外的 personal agent 也值得试试,比如让它帮着管娱乐、管社交。这块我还没动手,后面准备自己搞一个。
结语
回到标题,AI 时代怎么成为一个 AI Native 的工程师?落到行动上就是三步。
先认清写代码已经是最便宜的事,把精力放到最贵的那两件事上:一开始让 AI 做对的事,最后能证明它把事做对了。
再把写代码之外的活也交给 AI。从自己的工作流或者痛点入手,一块块拆成小能力,能交出去的都交出去。
最后把这些能力整合成自己的 personal agent,让它替你干活。
真做到这一步,大部分活就都不用你亲自动手了。不过有两样东西始终得攥在自己手里:要做什么,以及做得对不对。要是连这两样也交出去,那你和 Agent 也就没什么区别了。
参考资料
- The AI-native SDLC playbook — Louis Claxton · Anthropic · 2026.08
- MCP is dead. Long live the CLI — EJ Holmes · 2026.02